
Reinforcement learning multi-agente (MARL): cos’è, come funziona e a cosa serve
Cos'è il reinforcement learning multi-agente (MARL): sfide, approcci CTDE, algoritmi come QMIX e MAPPO, esempi celebri e applicazioni concrete.
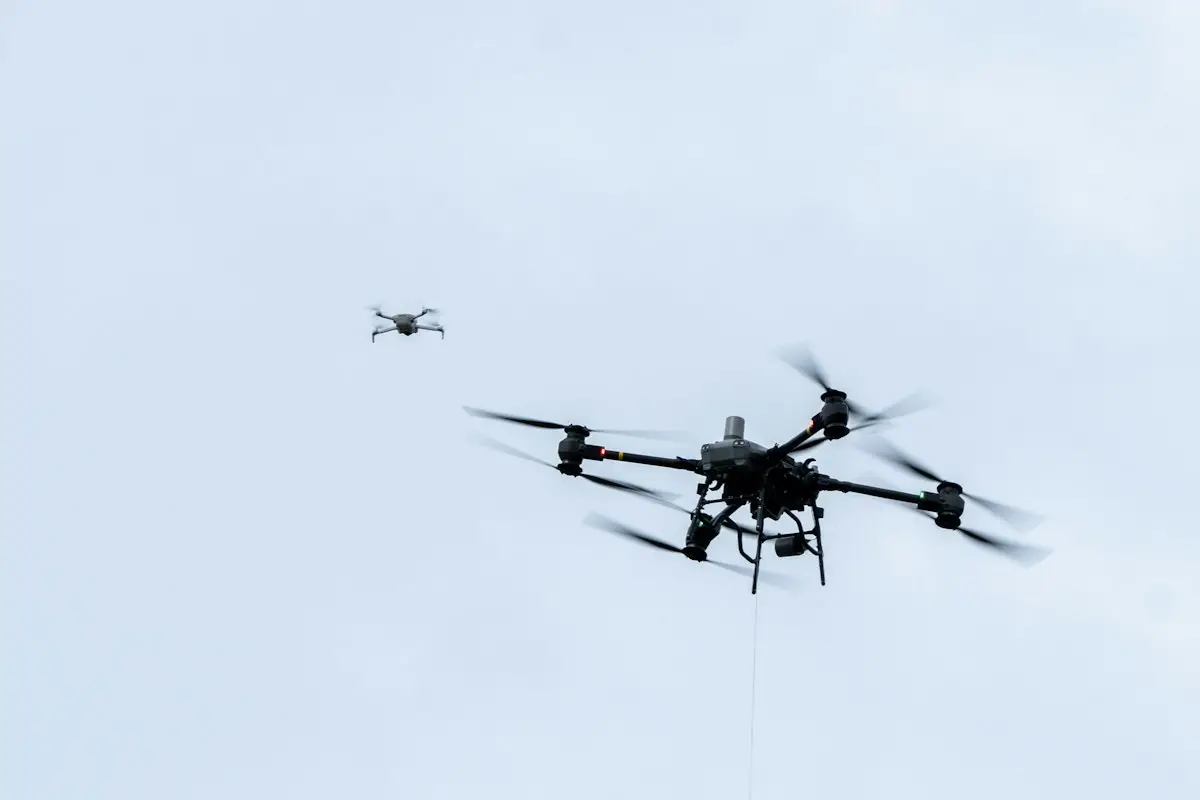
Quando un solo agente impara a giocare a scacchi o a muovere un braccio robotico, il mondo intorno a lui resta tutto sommato prevedibile: le regole non cambiano mentre si allena. Ma la maggior parte dei problemi reali non funziona così. Le auto condividono la strada con altre auto, i robot di un magazzino si incrociano negli stessi corridoi, gli algoritmi di trading reagiscono gli uni agli altri in frazioni di secondo. Qui entra in gioco il reinforcement learning multi-agente, in sigla MARL (Multi-Agent Reinforcement Learning), la branca dell’apprendimento per rinforzo che studia come più agenti possano imparare contemporaneamente nello stesso ambiente, collaborando, competendo o facendo entrambe le cose.
In questa guida trovi una spiegazione completa e senza formule superflue: cos’è il MARL, in cosa si differenzia dal reinforcement learning classico, quali sono le sue sfide tipiche, gli algoritmi più noti, gli esempi celebri e le applicazioni concrete. Alla fine avrai una mappa chiara per orientarti e, se vuoi, per iniziare a sperimentare.
Cos’è il reinforcement learning multi-agente
Per capire il MARL conviene partire dalle basi. Nel reinforcement learning tradizionale un singolo agente osserva lo stato dell’ambiente, sceglie un’azione, riceve una ricompensa e aggiorna la propria strategia, chiamata policy, per massimizzare la ricompensa cumulata nel tempo. Se vuoi ripassare il meccanismo di fondo, trovi tutto nella guida su cos’è l’apprendimento per rinforzo e come funziona.
Nel reinforcement learning multi-agente lo schema si moltiplica. Ci sono due o più agenti, ciascuno con le proprie osservazioni, le proprie azioni e, spesso, le proprie ricompense. Il punto cruciale è che le azioni di ogni agente modificano l’ambiente in cui imparano anche tutti gli altri.
In altre parole, per ogni agente gli altri agenti fanno parte dell’ambiente. E siccome anche loro stanno imparando, quell’ambiente cambia di continuo.
Dal processo di Markov al gioco stocastico
Il reinforcement learning a singolo agente si formalizza di solito con il processo decisionale di Markov, che descrive stati, azioni, probabilità di transizione e ricompense. Quando gli agenti diventano più di uno, il modello di riferimento si chiama gioco stocastico, o gioco di Markov: lo stato successivo dipende dall’azione congiunta di tutti gli agenti, cioè dalla combinazione delle scelte di ciascuno, e ogni agente riceve una ricompensa che può dipendere anche da ciò che hanno fatto gli altri.
Quando ogni agente vede solo una parte dell’ambiente, come accade quasi sempre nella realtà, si parla di modelli parzialmente osservabili. Nel caso cooperativo la formulazione più citata è il Dec-POMDP (processo decisionale di Markov decentralizzato e parzialmente osservabile), in cui tutti gli agenti condividono un obiettivo comune ma ognuno decide sulla base delle sole informazioni locali.
Non serve padroneggiare la matematica per seguire il resto della guida. Basta ricordare un’idea: nel MARL la ricompensa che ottieni dipende anche da chi ti sta intorno.
Cooperazione, competizione e scenari misti
Il primo criterio per classificare un problema multi-agente è il rapporto tra gli obiettivi degli agenti. Gli scenari si dividono in tre grandi famiglie, e ciascuna richiede approcci diversi.
Negli scenari cooperativi tutti gli agenti condividono la stessa ricompensa o obiettivi perfettamente allineati. È il caso di una squadra di robot che deve spostare un carico pesante, di un gruppo di droni che esplora un’area o dei semafori di una città che devono ridurre il traffico complessivo. La difficoltà principale qui è il coordinamento.
Negli scenari competitivi gli obiettivi sono opposti: ciò che guadagna un agente lo perde l’altro. I giochi a somma zero, come gli scacchi, il Go o il poker uno contro uno, ne sono l’esempio classico. In questi contesti il concetto chiave diventa la strategia robusta, quella che funziona bene anche contro l’avversario migliore possibile.
Gli scenari misti sono i più realistici e i più complessi. Gli agenti hanno interessi in parte comuni e in parte divergenti: pensa alle auto in un incrocio, che vogliono tutte evitare incidenti ma ognuna vorrebbe passare per prima, oppure a due squadre che si affrontano, dove si coopera con i compagni e si compete con gli avversari.
Capire in quale famiglia ricade il tuo problema è il primo passo per scegliere l’algoritmo giusto.
Perché il MARL è più difficile del reinforcement learning classico
Aggiungere agenti non significa semplicemente moltiplicare il lavoro. Introduce problemi qualitativamente nuovi, che non esistono quando un agente impara da solo. Conoscerli ti aiuta a capire perché gli algoritmi multi-agente sono costruiti in un certo modo.
La non stazionarietà
Gran parte degli algoritmi di reinforcement learning dà per scontato che l’ambiente sia stazionario, cioè che le sue regole non cambino nel tempo. Su questa ipotesi poggiano molte garanzie teoriche di convergenza, per esempio quelle del Q-learning.
In un sistema multi-agente l’ipotesi salta. Mentre l’agente A impara, anche l’agente B modifica la propria strategia, e quindi la stessa azione di A può produrre risultati diversi da un giorno all’altro di addestramento. È come cercare di colpire un bersaglio che si sposta proprio perché tu stai migliorando la mira.
Il risultato pratico può essere un apprendimento instabile, con strategie che oscillano senza mai assestarsi.
Il problema dell’attribuzione del merito
Quando la squadra riceve una ricompensa comune, come fa il singolo agente a capire quanto ha contribuito al risultato? Se cinque robot spostano insieme una cassa e ottengono un premio, magari uno di loro non ha fatto nulla di utile o ha addirittura ostacolato gli altri, ma riceve comunque la stessa ricompensa.
Questo è il problema dell’attribuzione del merito multi-agente, noto in inglese come credit assignment. Senza un modo per distinguere i contributi individuali, gli agenti possono imparare comportamenti pigri, affidandosi al lavoro dei compagni, o non imparare affatto.
L’esplosione combinatoria
Lo spazio delle azioni congiunte cresce in modo esponenziale con il numero degli agenti. Se ogni agente ha dieci azioni possibili, due agenti producono cento combinazioni, cinque agenti centomila, dieci agenti dieci miliardi.
Trattare l’intero sistema come un unico super agente che controlla tutto diventa presto impraticabile. Per questo il MARL cerca soluzioni che permettano a ciascun agente di decidere in modo il più possibile indipendente, senza perdere il coordinamento.
Osservabilità parziale e comunicazione
Nella maggior parte dei casi reali nessun agente vede tutto. Un drone percepisce solo la porzione di territorio sotto di sé, un’auto vede solo i veicoli vicini. Gli agenti devono quindi agire con informazioni incomplete e, a volte, imparare a comunicare tra loro per colmare le lacune.
La comunicazione apre però nuove domande: cosa conviene dire, a chi, con quale frequenza e con quale costo. In alcune linee di ricerca gli agenti sviluppano veri e propri protocolli di comunicazione appresi, senza che nessuno li abbia progettati a mano.
Il dilemma dell’esplorazione, moltiplicato
Ogni agente di reinforcement learning deve bilanciare la scoperta di nuove azioni con lo sfruttamento di ciò che già funziona, un tema che approfondiamo nella guida su esplorazione e sfruttamento nel reinforcement learning. Con più agenti il problema si complica: l’esplorazione di uno introduce rumore nell’esperienza degli altri, che possono trarre conclusioni sbagliate da comportamenti casuali dei compagni.
Alcune strategie cooperative efficaci, inoltre, richiedono che più agenti esplorino in modo coordinato nello stesso momento, cosa che difficilmente accade per puro caso.
Gli approcci principali all’addestramento
Per affrontare queste sfide la ricerca ha sviluppato diversi paradigmi di addestramento. Si possono ordinare lungo un asse che va dalla massima indipendenza degli agenti al massimo controllo centralizzato.
Apprendimento indipendente
L’approccio più semplice consiste nel far imparare ogni agente come se fosse solo, trattando gli altri come parte dell’ambiente. L’esempio storico è l’Independent Q-Learning, in cui ogni agente esegue il proprio Q-learning ignorando la presenza degli altri.
Il vantaggio è la semplicità: puoi riusare qualunque algoritmo a singolo agente e il sistema scala bene. Lo svantaggio è che si scontra in pieno con la non stazionarietà, senza alcuna contromisura. Eppure, a sorpresa, in molti scenari funziona meglio di quanto la teoria lascerebbe pensare, e varianti indipendenti di algoritmi moderni restano baseline competitive.
Apprendimento completamente centralizzato
All’estremo opposto c’è l’idea di trattare tutti gli agenti come un’unica entità, con un solo controllore che osserva tutto e sceglie l’azione congiunta. In teoria elimina il problema del coordinamento, ma in pratica soffre dell’esplosione combinatoria descritta sopra e richiede che durante l’uso esista un canale di comunicazione perfetto verso un’unità centrale.
Funziona solo con pochi agenti e in ambienti controllati.
Addestramento centralizzato, esecuzione decentralizzata
Il compromesso che oggi domina la ricerca cooperativa si chiama CTDE, Centralized Training with Decentralized Execution. L’idea è elegante: durante l’addestramento, che avviene in simulazione, si sfruttano tutte le informazioni disponibili, comprese le osservazioni e le azioni di tutti gli agenti. Durante l’esecuzione, invece, ogni agente decide da solo usando esclusivamente le proprie osservazioni locali.
In questo modo si mitigano la non stazionarietà e il problema dell’attribuzione del merito in fase di apprendimento, ma si ottengono agenti autonomi che non dipendono da un controllore centrale quando vengono messi al lavoro. Molti degli algoritmi più noti del MARL cooperativo seguono questo schema.
Se ricordi una sola sigla di questa guida, ricorda CTDE.
Self-play e apprendimento a popolazione
Negli scenari competitivi una tecnica centrale è il self-play: l’agente si allena giocando contro copie di sé stesso, che migliorano insieme a lui. Così dispone sempre di un avversario del livello giusto, né troppo debole né troppo forte.
Il rischio del self-play puro è che l’agente si specializzi a battere solo la versione corrente di sé stesso, dimenticando come contrastare strategie diverse. Per questo si usano spesso popolazioni di agenti, archivi di versioni passate contro cui continuare ad allenarsi e meccanismi che premiano la diversità delle strategie.
Gli algoritmi di MARL più noti
Il panorama degli algoritmi è vasto e in continua evoluzione. Quelli che seguono sono punti di riferimento citati in moltissimi lavori e utili per orientarti nella letteratura.
Metodi basati sulla scomposizione del valore
Una famiglia importante di algoritmi cooperativi parte da una domanda: è possibile scomporre il valore della squadra nella somma, o in una combinazione, dei valori dei singoli agenti? Se sì, ogni agente può scegliere l’azione migliore per sé e, automaticamente, il risultato è buono anche per la squadra.
VDN (Value Decomposition Networks) assume che il valore congiunto sia la semplice somma dei valori individuali. QMIX, proposto nel 2018, generalizza l’idea con una rete di miscelazione che combina i valori individuali in modo non lineare, imponendo però un vincolo di monotonia: se il valore di un singolo agente aumenta, il valore della squadra non può diminuire. Questo vincolo garantisce coerenza tra le scelte locali e l’obiettivo globale, pur limitando i tipi di cooperazione che il modello riesce a rappresentare.
Sono metodi molto usati come riferimento negli ambienti cooperativi con azioni discrete.
Metodi actor-critic multi-agente
Un’altra famiglia adatta il paradigma actor-critic al contesto multi-agente. Ogni agente ha un attore, cioè la policy che decide le azioni usando solo le osservazioni locali, mentre il critico, usato solo in addestramento, valuta le azioni avendo accesso alle informazioni di tutti. È l’applicazione diretta del principio CTDE.
MADDPG, presentato nel 2017, estende questa idea ad ambienti con azioni continue e a scenari sia cooperativi sia competitivi. COMA affronta esplicitamente l’attribuzione del merito con un ragionamento controfattuale: per stimare il contributo di un agente, confronta la ricompensa ottenuta con quella che si sarebbe ottenuta se quell’agente avesse agito diversamente, a parità di azioni degli altri.
MAPPO e il ritorno dei metodi on-policy
Negli ultimi anni ha guadagnato molta attenzione MAPPO, l’adattamento multi-agente di Proximal Policy Optimization, l’algoritmo che puoi approfondire nella guida dedicata a policy gradient e PPO. Diversi studi hanno mostrato che PPO, con un critico centralizzato e alcuni accorgimenti di implementazione, raggiunge risultati molto competitivi su benchmark cooperativi diffusi, spesso con una messa a punto più semplice rispetto ad algoritmi più sofisticati.
È un buon promemoria di un fatto ricorrente nel machine learning: i dettagli di implementazione contano quanto l’idea teorica.
Equilibri e teoria dei giochi
Negli scenari competitivi e misti non esiste una sola strategia ottimale in assoluto, perché il risultato dipende da cosa fanno gli altri. Per questo il MARL prende in prestito concetti dalla teoria dei giochi, a partire dall’equilibrio di Nash: una combinazione di strategie in cui nessun agente ha interesse a cambiare la propria, se gli altri mantengono le loro.
Diversi algoritmi cercano di convergere verso equilibri di questo tipo o verso strategie difficili da sfruttare. Nei giochi a informazione imperfetta, come il poker, approcci basati sulla minimizzazione del rimpianto controfattuale hanno permesso di raggiungere livelli di gioco superiori a quelli dei professionisti umani.
Esempi celebri di reinforcement learning multi-agente
Alcuni risultati hanno portato il MARL all’attenzione del grande pubblico, mostrando che più agenti che imparano insieme possono sviluppare comportamenti sorprendentemente sofisticati.
OpenAI Five e Dota 2
OpenAI Five era un sistema composto da cinque reti neurali, una per ciascun eroe di una squadra di Dota 2, un videogioco strategico in tempo reale molto complesso. Addestrato con un’enorme quantità di partite giocate contro sé stesso, nel 2019 ha battuto la squadra campione del mondo in carica, OG.
L’aspetto interessante è che i cinque agenti hanno imparato a coordinarsi come una squadra, senza istruzioni esplicite su come farlo.
AlphaStar e StarCraft II
DeepMind ha sviluppato AlphaStar per giocare a StarCraft II, un altro gioco di strategia in tempo reale con informazione incompleta e un enorme spazio di azioni. Il sistema è stato addestrato con una combinazione di apprendimento da partite umane e reinforcement learning su una lega di agenti, una popolazione in cui alcuni agenti avevano il compito specifico di scoprire e sfruttare le debolezze degli altri. Nel 2019 AlphaStar ha raggiunto il livello Grandmaster nel sistema di classifiche ufficiale del gioco.
La lega di agenti è un esempio concreto di come l’apprendimento a popolazione aiuti a evitare strategie fragili.
Nascondino e uso emergente di strumenti
Nel 2019 un esperimento di OpenAI ha messo squadre di agenti a giocare a nascondino in un ambiente fisico simulato, con oggetti spostabili come scatole e rampe. Con il passare dell’addestramento gli agenti hanno sviluppato una sequenza di strategie e contro strategie: chi si nascondeva ha imparato a costruire rifugi con le scatole, chi cercava ha imparato a usare le rampe per scavalcarli, e così via, fino a comportamenti che i ricercatori non avevano previsto.
È un esempio efficace di autocurriculum: la competizione tra agenti genera da sola una progressione di sfide sempre più difficili.
Applicazioni concrete del MARL
I giochi sono un ottimo banco di prova, perché offrono regole chiare e simulazioni veloci. Le applicazioni che interessano davvero aziende e istituzioni, però, sono altrove. Molte sono ancora in fase di ricerca o sperimentazione, ma il potenziale è ampio ovunque ci siano più decisori autonomi che interagiscono.
Traffico e mobilità
Il controllo dei semafori è uno dei casi di studio più esplorati: ogni incrocio è un agente che decide i tempi del verde, e l’obiettivo comune è ridurre code e tempi di attesa sull’intera rete. Nello stesso ambito rientrano la guida autonoma in presenza di altri veicoli e la gestione di flotte di mezzi condivisi o di taxi.
Robotica e sciami di droni
Nei magazzini automatizzati decine di robot devono muoversi senza scontrarsi e smistare gli ordini nel minor tempo possibile. Gruppi di droni possono coordinarsi per ispezioni, mappature o operazioni di ricerca e soccorso. Il MARL offre strumenti per apprendere politiche di coordinamento che scalano meglio delle regole scritte a mano, anche se il passaggio dalla simulazione al mondo reale resta una sfida aperta.
Energia e reti
Nelle reti elettriche intelligenti più produttori, accumulatori e consumatori devono bilanciare domanda e offerta. Il MARL viene studiato per gestire la ricarica dei veicoli elettrici, il controllo distribuito delle microreti e l’ottimizzazione delle reti di telecomunicazione, dove ogni nodo prende decisioni locali con effetti sull’intero sistema.
Economia, finanza e simulazioni
Simulare mercati popolati da agenti che apprendono permette di studiare dinamiche difficili da osservare altrimenti, come la formazione dei prezzi o la risposta a nuove regole. Il MARL è usato anche per progettare meccanismi d’asta, studiare politiche economiche in ambienti simulati e testare strategie di trading in presenza di altri operatori adattivi.
Agenti AI basati su modelli linguistici
Una frontiera recente riguarda i sistemi in cui più agenti basati su modelli linguistici collaborano: uno pianifica, uno scrive codice, uno verifica il lavoro degli altri. Se vuoi un quadro generale su questi sistemi, leggi la guida su cosa sono e come funzionano gli agenti AI.
Oggi molti di questi sistemi sono orchestrati con regole e prompt più che addestrati con reinforcement learning multi-agente vero e proprio, ma i concetti del MARL, dal coordinamento all’attribuzione del merito, stanno diventando sempre più rilevanti anche qui. Capire come più agenti imparano insieme aiuta a progettare sistemi più robusti e a prevedere comportamenti emergenti indesiderati.
Strumenti e ambienti per iniziare a sperimentare
Se vuoi passare dalla teoria alla pratica, l’ecosistema open source offre diversi punti di partenza. Ti serve una buona base di Python e di reinforcement learning a singolo agente, possibilmente anche di deep learning.
Per gli ambienti di simulazione, PettingZoo, mantenuto dalla Farama Foundation, è di fatto lo standard per gli ambienti multi-agente in Python: offre un’interfaccia comune e una raccolta di ambienti che va dai giochi classici a scenari cooperativi con particelle. SMAC, la StarCraft Multi-Agent Challenge, è un benchmark cooperativo molto citato in cui squadre di unità devono affrontare il nemico in micro scenari di combattimento. Altri ambienti noti sono Google Research Football e il gioco di carte cooperativo Hanabi, interessante perché richiede di ragionare su ciò che i compagni sanno e non sanno.
Per gli algoritmi, RLlib, parte dell’ecosistema Ray, supporta l’addestramento multi-agente e la distribuzione su più macchine. Esistono poi librerie di ricerca come EPyMARL, che raccolgono implementazioni di riferimento di algoritmi cooperativi come QMIX e MAPPO, utili per confrontare approcci diversi a parità di condizioni.
Un consiglio pratico: inizia da ambienti piccoli e veloci, con due o tre agenti, prima di passare a scenari complessi.
Un percorso di studio consigliato
Per costruire competenze solide ti conviene procedere per gradi. Prima consolida il reinforcement learning classico: processi di Markov, Q-learning, metodi policy gradient, poi il passaggio al deep reinforcement learning. Poi affronta i concetti base della teoria dei giochi, in particolare gli equilibri e i giochi a somma zero.
A quel punto puoi implementare un apprendimento indipendente su un ambiente semplice, osservarne i limiti e confrontarlo con un algoritmo CTDE. Vedere con i tuoi occhi l’instabilità dovuta alla non stazionarietà vale più di molte pagine di teoria.
Limiti, rischi e questioni aperte
Il MARL è un campo vivace, ma porta con sé limiti tecnici e domande importanti che vale la pena conoscere prima di adottarlo.
Il primo limite è il costo computazionale. I risultati più spettacolari, come quelli su Dota 2 e StarCraft II, hanno richiesto quantità di calcolo enormi e infrastrutture di simulazione su larga scala, fuori dalla portata della maggior parte delle organizzazioni. Per problemi industriali servono simulatori fedeli e veloci, che spesso non esistono e vanno costruiti da zero.
Il secondo è la riproducibilità. I risultati del MARL sono notoriamente sensibili agli iperparametri, ai semi casuali e ai dettagli di implementazione, e i confronti tra algoritmi possono cambiare in base alle condizioni sperimentali. Nella letteratura è emersa da tempo l’esigenza di protocolli di valutazione più rigorosi.
C’è poi il tema dei comportamenti emergenti. Quando più agenti ottimizzano ciascuno la propria ricompensa possono nascere strategie inattese, talvolta indesiderate: collusione, sfruttamento di falle dell’ambiente, dinamiche instabili. È una versione collettiva del problema della specifica della ricompensa, che trovi descritto nella nostra guida sulla funzione di ricompensa.
Infine c’è il trasferimento al mondo reale. Una politica che funziona perfettamente in simulazione può fallire quando l’ambiente reale differisce anche di poco, e con più agenti gli errori possono propagarsi e amplificarsi.
Nessuno di questi limiti rende il MARL meno interessante. Indicano semplicemente dove si concentra la ricerca dei prossimi anni.
Le domande più frequenti sul MARL
Il MARL è la stessa cosa dei sistemi multi-agente?
No. I sistemi multi-agente sono un campo più ampio, che comprende anche agenti governati da regole, pianificatori e protocolli di negoziazione progettati a mano. Il MARL è la parte di questo campo in cui gli agenti imparano il proprio comportamento attraverso il reinforcement learning.
Serve sempre un simulatore?
Nella pratica quasi sempre. Il reinforcement learning richiede moltissime interazioni con l’ambiente, e con più agenti il fabbisogno cresce. Esistono approcci offline che imparano da dati raccolti in precedenza, ma restano un’area di ricerca più che una soluzione pronta all’uso.
Quando conviene davvero usarlo?
Ha senso quando il problema è intrinsecamente distribuito, cioè quando ci sono più decisori che devono agire in autonomia e interagiscono tra loro, e quando le soluzioni basate su regole o su un controllo centralizzato non scalano. Se un singolo agente o un algoritmo di ottimizzazione classico risolvono il problema, di solito sono la scelta più semplice ed efficiente.
Conclusioni
Il reinforcement learning multi-agente estende l’apprendimento per rinforzo a un mondo in cui non si decide mai da soli. Porta con sé sfide nuove, come la non stazionarietà, l’attribuzione del merito e l’esplosione combinatoria, ma anche soluzioni eleganti come l’addestramento centralizzato con esecuzione decentralizzata, la scomposizione del valore e il self-play.
Dai videogiochi ai semafori, dai robot di magazzino alle reti elettriche, fino ai sistemi di agenti basati su modelli linguistici, la capacità di far imparare più agenti insieme diventerà sempre più importante man mano che l’intelligenza artificiale passa da strumenti isolati a ecosistemi di sistemi che interagiscono.
Se questa guida ti è stata utile, continua il percorso con gli altri approfondimenti sull’apprendimento per rinforzo del nostro sito e prova a mettere le mani su un ambiente di PettingZoo: è il modo migliore per trasformare questi concetti in competenze concrete.
Tutta l'AI della settimana, in 5 minuti, nella tua email
- Le guide e le notizie della settimana, divise per rubrica
- Solo ciò che conta, verificato e spiegato in italiano
- Niente spam, ti cancelli con un clic

Daniele Della Corte
Fondatore di IntelligenzaArtificiale.net · Consulente SEO e AI dal 2008
Prima della pubblicazione controlla fonti, numeri e nomi, e risponde personalmente di quello che leggi. Lavora con l'intelligenza artificiale da oltre 7 anni: ha fondato BeProud.ai e ha progettato la redazione di questo sito.
Consulenza AIVuoi applicare l'AI al tuo lavoro? Ti aiuto a scegliere cosa automatizzare e a realizzarlo.
Scopri la consulenza