AlphaGo, AlphaZero e MuZero: come il reinforcement learning ha conquistato i giochi
Da AlphaGo a MuZero: come DeepMind ha usato apprendimento per rinforzo, reti neurali e ricerca Monte Carlo per battere i campioni umani.
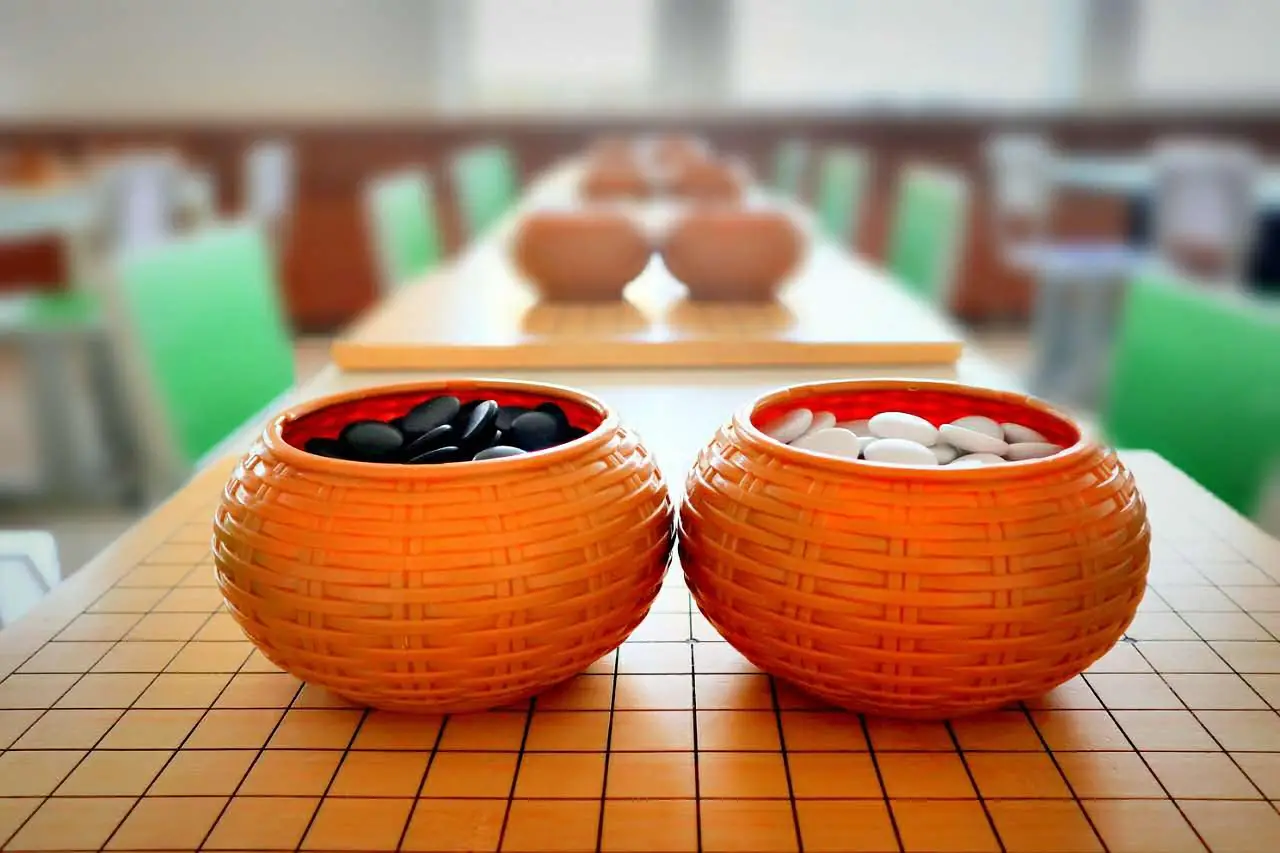
Quando si parla di intelligenza artificiale che impara da sola, prima o poi si arriva sempre lì: a una scacchiera, a un goban, a una partita di videogioco. Non è un caso. I giochi sono stati per decenni il banco di prova preferito della ricerca, e la serie di sistemi sviluppati da DeepMind, da AlphaGo ad AlphaZero fino a MuZero, ha mostrato al mondo cosa può fare l’apprendimento per rinforzo quando viene combinato con le reti neurali profonde e con una buona strategia di ricerca. In questa guida ripercorri la storia di questi sistemi, capisci come funzionano davvero sotto il cofano, scopri perché i giochi sono un laboratorio così prezioso e cosa resta oggi di quelle idee nei modelli che usi tutti i giorni.
Perché i giochi sono il laboratorio ideale dell’intelligenza artificiale
Prima di entrare nei dettagli di AlphaGo conviene capire perché i ricercatori hanno sempre amato i giochi. Un gioco da tavolo ha regole precise, uno spazio di azioni ben definito e, soprattutto, un risultato misurabile: vinci, perdi o pareggi. Questa chiarezza è oro per chi sviluppa algoritmi, perché permette di confrontare in modo oggettivo un approccio con un altro e di misurare i progressi senza ambiguità.
C’è poi un secondo vantaggio, meno evidente ma decisivo. Un gioco si può simulare al computer milioni di volte, a costo quasi nullo e senza rischi. Nessun robot si rompe, nessun paziente corre pericoli, nessun mercato finanziario viene perturbato. Un agente può sbagliare tutte le volte che vuole e imparare dai propri errori.
È esattamente ciò di cui ha bisogno l’apprendimento per rinforzo.
Se non hai familiarità con il concetto, l’idea di base è semplice: un agente compie azioni in un ambiente, riceve una ricompensa positiva o negativa e, partita dopo partita, impara quali comportamenti massimizzano la ricompensa nel lungo periodo. Trovi una spiegazione completa nella nostra guida su cos’è l’apprendimento per rinforzo e come funziona. Nei giochi la ricompensa è naturale, perché coincide con il risultato finale della partita.
Dagli scacchi di Deep Blue al backgammon di TD-Gammon
La storia dell’AI nei giochi non comincia con DeepMind. Nel 1997 Deep Blue di IBM sconfisse il campione del mondo di scacchi Garry Kasparov in un match diventato leggendario. Va però chiarito un punto spesso frainteso: Deep Blue non imparava nel senso moderno del termine. Era un sistema basato su una ricerca enorme tra le mosse possibili, supportata da hardware dedicato e da una funzione di valutazione costruita a mano da esperti, con migliaia di parametri regolati con cura.
Qualche anno prima, all’inizio degli anni Novanta, Gerald Tesauro di IBM aveva sviluppato TD-Gammon, un programma di backgammon che imparava giocando contro se stesso grazie a una tecnica chiamata temporal difference learning, abbinata a una piccola rete neurale. TD-Gammon raggiunse un livello vicino a quello dei migliori giocatori umani e suggerì alcune strategie che gli esperti adottarono in seguito.
In quei due sistemi c’erano già, in germe, le due anime che AlphaGo avrebbe fuso insieme: la ricerca tra le mosse e l’apprendimento dall’esperienza.
Il problema del Go: troppe mosse per la forza bruta
Per gli scacchi la ricerca a forza bruta, opportunamente potata, si era rivelata sufficiente. Il Go invece resisteva. Questo antico gioco di origine cinese si gioca su una griglia di 19 per 19 intersezioni, con regole elementari ma una complessità enorme. A ogni turno un giocatore ha in media molte più mosse legali rispetto agli scacchi, e le partite durano molto più a lungo. Il numero di posizioni possibili è talmente grande da superare di gran lunga il numero di atomi stimato nell’universo osservabile.
Il problema più serio, però, non era solo il numero di mosse. Negli scacchi è relativamente facile scrivere una funzione che valuti una posizione, contando i pezzi e alcuni fattori strategici. Nel Go stabilire chi sta vincendo a metà partita è difficilissimo anche per un essere umano esperto, che si affida spesso a un’intuizione costruita in anni di pratica.
Per molto tempo si è pensato che un programma capace di battere i professionisti di Go fosse lontano almeno un decennio.
AlphaGo: la vittoria che ha cambiato la percezione dell’AI
AlphaGo è stato sviluppato da DeepMind, il laboratorio londinese acquisito da Google nel 2014. Nell’ottobre del 2015 sconfisse per cinque partite a zero Fan Hui, campione europeo di Go, diventando il primo programma a battere un professionista su una scacchiera regolamentare senza handicap. La notizia fu resa pubblica all’inizio del 2016 con un articolo sulla rivista Nature.
Il vero banco di prova arrivò nel marzo 2016 a Seul, contro Lee Sedol, uno dei giocatori più forti e titolati dell’epoca. AlphaGo vinse la serie per quattro partite a una. Milioni di persone seguirono gli incontri in diretta, soprattutto in Asia, dove il Go ha un valore culturale paragonabile a quello che in Occidente si attribuisce agli scacchi.
La mossa 37 e la mossa 78
Due momenti di quella sfida sono entrati nella storia. Nella seconda partita AlphaGo giocò la famosa mossa 37, una pietra posizionata in un punto che i commentatori professionisti giudicarono inizialmente un errore. Secondo le stime del sistema stesso, un giocatore umano avrebbe scelto quella mossa con una probabilità bassissima. Con il passare della partita apparve chiaro che era una mossa brillante, frutto di una comprensione del gioco diversa da quella umana.
Nella quarta partita fu Lee Sedol a stupire tutti con la sua mossa 78, una giocata inattesa che mandò in confusione AlphaGo e gli valse l’unica vittoria della serie. Quella partita è ricordata come la prova che anche un sistema fortissimo può avere punti ciechi, e che la creatività umana non era stata spazzata via.
Entrambe le mosse raccontano qualcosa di importante: l’AI non si era limitata a imitare gli umani, aveva trovato idee nuove.
Come funzionava AlphaGo
La versione che affrontò Lee Sedol combinava tre ingredienti principali. Il primo era una rete neurale chiamata policy network, addestrata inizialmente con apprendimento supervisionato su un vasto archivio di partite giocate da esseri umani esperti. Il suo compito era prevedere quali mosse fossero più promettenti in una data posizione, restringendo così il campo delle opzioni da esplorare.
Il secondo ingrediente era l’apprendimento per rinforzo. Dopo la fase di imitazione, la policy network veniva migliorata facendola giocare contro versioni precedenti di se stessa: le mosse che portavano alla vittoria venivano rafforzate, quelle che portavano alla sconfitta penalizzate. Da queste partite veniva poi addestrata una seconda rete, la value network, capace di stimare la probabilità di vittoria a partire da una posizione. Era proprio l’intuizione che mancava ai programmi precedenti.
Il terzo ingrediente era la ricerca ad albero Monte Carlo, nota con la sigla MCTS (Monte Carlo Tree Search).
La ricerca ad albero Monte Carlo spiegata semplice
Immagina di trovarti davanti a una posizione e di voler capire quale mossa giocare. Invece di analizzare tutte le varianti possibili, cosa impossibile nel Go, la ricerca Monte Carlo costruisce gradualmente un albero di possibilità, concentrandosi sui rami più promettenti. A ogni iterazione scende lungo l’albero scegliendo le mosse in base a un equilibrio tra quelle che finora sono sembrate buone e quelle ancora poco esplorate, valuta la posizione raggiunta e propaga il risultato verso l’alto, aggiornando le statistiche di ogni nodo attraversato.
Questo bilanciamento tra provare strade note e tentarne di nuove è un tema centrale di tutto l’apprendimento per rinforzo, che puoi approfondire nel nostro articolo sul dilemma tra esplorazione e sfruttamento.
In AlphaGo le reti neurali rendevano la ricerca molto più efficiente. La policy network suggeriva quali rami valesse la pena esplorare, mentre la value network permetteva di valutare una posizione senza doverla giocare fino alla fine. Il risultato era una ricerca molto più mirata di quella dei motori tradizionali, che esaminava un numero di posizioni assai inferiore rispetto a Deep Blue ma le sceglieva con molta più intelligenza.
Da AlphaGo Master alla sfida con Ke Jie
Dopo Seul, DeepMind continuò a migliorare il sistema. All’inizio del 2017 una versione chiamata AlphaGo Master giocò online, in forma anonima, contro alcuni dei migliori professionisti del mondo, vincendo tutte le partite disputate. Nel maggio 2017, in Cina, AlphaGo affrontò Ke Jie, allora numero uno del ranking mondiale, battendolo per tre partite a zero. Subito dopo DeepMind annunciò il ritiro di AlphaGo dalle competizioni ufficiali.
La storia, però, era tutt’altro che finita.
AlphaGo Zero: imparare partendo da zero
Nell’ottobre 2017 DeepMind pubblicò su Nature un nuovo articolo dedicato ad AlphaGo Zero. La differenza rispetto al predecessore era radicale: questa volta il sistema non vedeva nemmeno una partita umana. Conosceva solo le regole del gioco e imparava esclusivamente giocando contro se stesso, a partire da mosse completamente casuali.
I risultati furono sorprendenti. Dopo pochi giorni di addestramento AlphaGo Zero era in grado di battere la versione che aveva sconfitto Lee Sedol, vincendo tutte le cento partite di un confronto diretto. Proseguendo l’addestramento superò anche AlphaGo Master. Nel corso del processo il sistema riscoprì da solo molte strategie classiche note ai giocatori umani, per poi abbandonarne alcune a favore di soluzioni nuove.
Il messaggio era potente: i dati umani, che sembravano indispensabili, potevano persino rappresentare un limite.
Una sola rete e un ciclo virtuoso
Dal punto di vista tecnico AlphaGo Zero era anche più semplice del predecessore. Al posto di due reti separate ne usava una sola, con due uscite: una che proponeva le probabilità delle mosse e una che stimava il valore della posizione. Inoltre eliminava i rollout, cioè le simulazioni rapide di partite fino alla fine che la prima versione usava per valutare le posizioni.
Il cuore del metodo è un ciclo che si autoalimenta. La rete guida la ricerca Monte Carlo, la ricerca produce scelte di mosse migliori di quelle che la rete da sola suggerirebbe, e queste scelte migliori diventano il bersaglio su cui la rete viene addestrata. A ogni giro la rete diventa più forte, la ricerca che la usa diventa più forte a sua volta, e così via. In questo senso la ricerca funziona come un insegnante che alza continuamente l’asticella.
Questo schema, che combina rete neurale, ricerca e autogioco, è il vero lascito tecnico della famiglia Alpha.
AlphaZero: un solo algoritmo per scacchi, shogi e Go
Il passo successivo fu chiedersi se lo stesso approccio potesse funzionare anche su giochi diversi. Alla fine del 2017 DeepMind presentò AlphaZero, descritto poi in modo completo in un articolo pubblicato su Science nel dicembre 2018. Lo stesso algoritmo, senza modifiche specifiche per ciascun gioco a parte le regole, imparò a giocare a scacchi, a shogi (gli scacchi giapponesi) e a Go partendo da zero.
Negli scacchi AlphaZero affrontò Stockfish, uno dei motori più forti dell’epoca, frutto di anni di lavoro della comunità e di conoscenza scacchistica codificata a mano. AlphaZero vinse nettamente la serie di partite. Nello shogi sconfisse Elmo, campione tra i programmi dedicati, e nel Go superò AlphaGo Zero.
Il dato più interessante, però, riguardava lo stile di gioco.
Uno stile nuovo che ha influenzato i grandi maestri
Gli osservatori notarono che AlphaZero giocava a scacchi in modo dinamico e sorprendentemente aggressivo, disposto a sacrificare materiale in cambio di vantaggi posizionali a lungo termine, con una predilezione per la mobilità dei pezzi e per la pressione sul re avversario. Diversi grandi maestri hanno raccontato di aver studiato le partite di AlphaZero per trovare ispirazione, e alcune idee si sono diffuse nel gioco umano di alto livello.
C’è poi un’eredità meno visibile ma molto concreta. Il successo di AlphaZero ha spinto la comunità open source a sviluppare progetti ispirati alla stessa architettura, come Leela Chess Zero, e ha contribuito a portare le reti neurali anche dentro motori tradizionali come Stockfish, che oggi integra una componente di valutazione basata su reti neurali.
Una curiosità utile: AlphaZero analizzava molte meno posizioni al secondo rispetto ai motori classici, ma le sceglieva meglio. È la stessa lezione di AlphaGo, portata all’estremo.
MuZero: vincere senza conoscere le regole
AlphaZero aveva un limite importante: per pianificare doveva conoscere le regole del gioco. La ricerca Monte Carlo richiede infatti di simulare cosa succede dopo ogni mossa, e per farlo serve un simulatore perfetto dell’ambiente. Nel mondo reale, però, raramente disponiamo di un modello esatto di come funzionano le cose.
MuZero, presentato da DeepMind alla fine del 2019 e pubblicato su Nature nel dicembre 2020, affronta proprio questo problema. Il sistema non riceve le regole: impara da solo un modello interno dell’ambiente e lo usa per pianificare.
Un modello appreso, ma solo di ciò che conta
L’aspetto più elegante di MuZero è il tipo di modello che impara. Non cerca di ricostruire in ogni dettaglio lo stato del gioco o i pixel dello schermo, operazione costosa e spesso inutile. Impara invece una rappresentazione astratta che serve solo a prevedere tre cose fondamentali per decidere: quale mossa conviene giocare, quanto vale la situazione attuale e quale ricompensa immediata si otterrà.
In pratica MuZero si chiede: cosa mi serve sapere del futuro per scegliere bene adesso? Tutto il resto viene ignorato.
Con questo approccio MuZero ha eguagliato le prestazioni di AlphaZero a Go, scacchi e shogi, e ha ottenuto risultati di primo piano anche sui videogiochi Atari, un ambito in cui le regole non sono esplicite e l’agente vede soltanto le immagini dello schermo. L’idea di imparare un modello interno del mondo per pianificare è oggi uno dei filoni più vivaci della ricerca, e la ritrovi nella nostra guida sui world model e su come funzionano.
Confronto tra le versioni
Per orientarti tra i nomi, ecco un riepilogo essenziale dell’evoluzione:
- AlphaGo (2015-2016): impara prima dalle partite umane, poi migliora con l’autogioco; usa due reti neurali, ricerca Monte Carlo e simulazioni rapide.
- AlphaGo Zero (2017): nessun dato umano, solo regole e autogioco; una sola rete con due uscite, niente simulazioni rapide.
- AlphaZero (2017-2018): lo stesso algoritmo generalizzato a scacchi, shogi e Go.
- MuZero (2019-2020): non conosce le regole, impara un modello interno e pianifica al suo interno, funzionando anche su Atari.
A ogni passaggio il sistema ha bisogno di meno conoscenza fornita dall’esterno. È questa la vera direzione di marcia.
Oltre i giochi da tavolo: videogiochi, poker e strategia
La famiglia Alpha non è l’unica storia di successo. Nello stesso periodo l’apprendimento per rinforzo ha conquistato altri tipi di giochi, ciascuno con sfide diverse rispetto al Go.
Atari e la nascita del deep reinforcement learning
Prima ancora di AlphaGo, DeepMind aveva attirato l’attenzione con DQN, un agente presentato nel 2013 e descritto su Nature nel 2015. DQN imparava a giocare a decine di classici videogiochi Atari osservando soltanto i pixel dello schermo e il punteggio, con lo stesso algoritmo per tutti i giochi. In molti titoli raggiungeva o superava il livello di un giocatore umano esperto.
DQN è considerato il punto di partenza del moderno deep reinforcement learning, perché ha dimostrato che una rete neurale profonda poteva imparare direttamente dall’esperienza grezza. Se vuoi approfondire le tecniche alla base, trovi tutto nella guida al deep reinforcement learning.
StarCraft II e Dota 2: informazione incompleta e tempo reale
I giochi di strategia in tempo reale pongono problemi molto diversi dal Go. Le azioni sono continue, il tempo scorre senza turni, la mappa è in parte nascosta e le partite richiedono pianificazione di lungo periodo e reazioni immediate allo stesso tempo.
Nel 2019 DeepMind ha presentato AlphaStar, che ha raggiunto il livello Grandmaster in StarCraft II, collocandosi tra i migliori giocatori della piattaforma online ufficiale. Nello stesso anno OpenAI Five, sviluppato da OpenAI, ha sconfitto la squadra campione del mondo di Dota 2, un gioco a squadre di cinque contro cinque che richiede coordinamento tra più agenti.
Questi sistemi hanno richiesto quantità enormi di calcolo e di partite simulate, ma hanno dimostrato che l’approccio funziona anche in ambienti caotici e parzialmente osservabili.
Il poker e il ruolo del bluff
Il poker è interessante per una ragione diversa: è un gioco a informazione incompleta, in cui non conosci le carte dell’avversario e devi gestire il bluff. Qui non basta trovare la mossa migliore, bisogna essere imprevedibili.
Nel 2017 Libratus, sviluppato alla Carnegie Mellon University, ha battuto alcuni professionisti di Texas Hold’em senza limiti in sfide uno contro uno. Nel 2019 Pluribus, frutto della collaborazione tra Carnegie Mellon e Facebook AI, è riuscito a battere professionisti in partite a sei giocatori. Questi sistemi si basano più su tecniche di teoria dei giochi e di minimizzazione del rimpianto che sulla ricerca Monte Carlo, ma condividono l’idea centrale dell’autogioco: migliorare giocando milioni di mani contro se stessi.
Cosa possiamo imparare dalla famiglia Alpha
Al di là dei record, perché questi risultati sono così importanti? Perché hanno messo in luce alcuni principi che vanno ben oltre i giochi e che ancora oggi orientano la ricerca.
L’autogioco come motore di miglioramento
Il primo principio è la potenza dell’autogioco. Un agente che gioca contro se stesso ha sempre un avversario del proprio livello: non troppo forte da risultare imbattibile, non troppo debole da non insegnare nulla. È una sorta di curriculum automatico, che cresce insieme all’agente.
Questa idea richiede però un ambiente simulabile e una ricompensa chiara. Nei giochi entrambe le condizioni sono soddisfatte; nel mondo reale molto meno.
La combinazione di intuizione e ragionamento
Il secondo principio riguarda l’unione tra due modi di pensare. La rete neurale rappresenta una sorta di intuizione rapida: guarda una posizione e suggerisce in un istante cosa sembra buono. La ricerca Monte Carlo rappresenta invece un ragionamento più lento e deliberato, che verifica le ipotesi guardando avanti nel futuro. Nessuno dei due, da solo, raggiunge le prestazioni della loro combinazione.
Questa distinzione ricorda molto da vicino quella tra pensiero veloce e pensiero lento descritta in psicologia cognitiva, ed è tornata d’attualità con i modelli linguistici di ragionamento, che dedicano più calcolo alla riflessione prima di rispondere. Il parallelo non va preso alla lettera, perché i meccanismi interni sono diversi, ma l’intuizione di fondo è la stessa: dare a un sistema più tempo per pensare può migliorare molto le sue decisioni.
Meno conoscenza umana, più generalità
Il terzo principio è forse il più discusso. Ogni versione della famiglia Alpha ha ridotto la quantità di conoscenza umana necessaria: prima le partite degli esperti, poi le regole specifiche, infine le regole stesse. E a ogni passaggio le prestazioni sono migliorate o rimaste al vertice.
Questo ha alimentato l’idea che metodi generali, capaci di sfruttare grandi quantità di calcolo, tendano nel lungo periodo a superare quelli costruiti con molta conoscenza specifica del dominio. È un’idea influente nella comunità scientifica, anche se non vale in modo assoluto: in molti casi la conoscenza degli esperti resta preziosa, soprattutto quando i dati sono scarsi o gli errori costano cari.
Dai giochi al mondo reale: le applicazioni concrete
DeepMind ha sempre presentato i giochi come un mezzo, non come un fine. L’obiettivo dichiarato era sviluppare metodi generali da applicare poi a problemi scientifici e industriali. Alcuni risultati sono arrivati.
Nel 2022 AlphaTensor ha usato un approccio ispirato ad AlphaZero per scoprire nuovi algoritmi di moltiplicazione tra matrici, trasformando la ricerca di un algoritmo efficiente in una sorta di gioco a un giocatore. Nel 2023 AlphaDev ha applicato un’idea simile alla ricerca di routine di ordinamento più veloci, alcune delle quali sono state integrate in una libreria standard del linguaggio C++. Anche MuZero è stato sperimentato su problemi pratici, come l’ottimizzazione della compressione video.
Va detto con chiarezza che non tutti i successi dei laboratori si traducono subito in applicazioni.
Il mondo reale è spesso difficile da simulare con precisione, le ricompense sono ambigue e un errore può avere conseguenze serie. Un robot non può cadere milioni di volte, e un sistema che gestisce una rete elettrica non può permettersi di sperimentare a caso. Per questo una parte importante della ricerca attuale si concentra su come trasferire ciò che un agente impara in simulazione verso ambienti reali, e su come definire ricompense che non vengano aggirate in modi inattesi.
L’eredità nei modelli linguistici di oggi
C’è infine un legame meno ovvio ma molto attuale. Le tecniche di apprendimento per rinforzo maturate anche grazie ai giochi sono oggi una componente fondamentale dell’addestramento dei grandi modelli linguistici. Dopo la fase iniziale di pre-addestramento, i modelli vengono affinati con varie forme di rinforzo, per esempio basate sul feedback umano o sulla verifica automatica delle risposte in matematica e programmazione.
Molti ricercatori che hanno lavorato ad AlphaGo e ai suoi successori si occupano oggi di questi temi. Le idee di autogioco, di ricerca guidata da una rete e di miglioramento iterativo continuano a circolare, adattate a un dominio, il linguaggio, molto meno ordinato di una scacchiera.
Domande frequenti su AlphaGo, AlphaZero e MuZero
AlphaGo è ancora il programma di Go più forte?
AlphaGo è stato ritirato dalle competizioni nel 2017 e superato dai suoi stessi successori. Oggi esistono programmi di Go, anche open source, ispirati alla stessa architettura e capaci di prestazioni ben superiori a quelle di qualsiasi giocatore umano. I professionisti li usano regolarmente per allenarsi e analizzare le partite.
Che differenza c’è tra AlphaZero e un motore di scacchi tradizionale?
Un motore tradizionale esamina un numero enorme di posizioni e le valuta con regole costruite o regolate dagli sviluppatori. AlphaZero esamina molte meno posizioni ma le sceglie e le valuta con una rete neurale che ha imparato da sola, giocando contro se stessa. Oggi i confini sono più sfumati, perché anche i motori classici integrano componenti neurali.
MuZero è un world model?
In senso ampio sì, perché impara un modello interno dell’ambiente e lo usa per pianificare. Si tratta però di un modello molto specifico, che non cerca di ricostruire il mondo in tutti i suoi dettagli ma solo le informazioni utili a prendere decisioni. Per questo viene spesso indicato come un esempio di apprendimento per rinforzo basato su modello.
Posso sperimentare queste tecniche da solo?
Sì, su scala ridotta. Esistono librerie e ambienti open source che permettono di addestrare agenti su giochi semplici, come il tris o il forza quattro, usando autogioco e ricerca Monte Carlo. Non otterrai un campione mondiale di Go, che ha richiesto risorse di calcolo enormi, ma capirai a fondo come funziona il ciclo tra rete neurale e ricerca.
Conclusioni
La storia di AlphaGo, AlphaZero e MuZero è molto più di una serie di vittorie contro campioni umani. È il racconto di come l’apprendimento per rinforzo, unito alle reti neurali profonde e a una ricerca intelligente, abbia dimostrato di poter scoprire strategie nuove, superare la conoscenza accumulata in secoli di pratica e, passo dopo passo, fare a meno di sempre più indicazioni esterne.
I giochi sono stati il laboratorio perfetto: regole chiare, risultati misurabili, simulazioni infinite. Le lezioni apprese, dall’autogioco all’unione tra intuizione e ragionamento, sono oggi parte integrante della ricerca sui modelli più avanzati, compresi quelli con cui interagisci ogni giorno.
Se vuoi continuare il percorso, parti dalle basi dell’apprendimento per rinforzo e prosegui con le guide dedicate alle singole tecniche nella sezione del sito dedicata a questo tema. E se hai una domanda o vuoi suggerirci un argomento da approfondire, scrivici: le guide migliori nascono spesso dalle curiosità dei lettori.
Tutta l'AI della settimana, in 5 minuti, nella tua email
- Le guide e le notizie della settimana, divise per rubrica
- Solo ciò che conta, verificato e spiegato in italiano
- Niente spam, ti cancelli con un clic
Daniele Della Corte
Fondatore di IntelligenzaArtificiale.net · Consulente SEO e AI dal 2008
Prima della pubblicazione controlla fonti, numeri e nomi, e risponde personalmente di quello che leggi. Lavora con l'intelligenza artificiale da oltre 7 anni: ha fondato BeProud.ai e ha progettato la redazione di questo sito.
Consulenza AIVuoi applicare l'AI al tuo lavoro? Ti aiuto a scegliere cosa automatizzare e a realizzarlo.
Scopri la consulenza