
BioBasicsBench: il test di OpenAI su AI e analisi in laboratorio
OpenAI e Ligo lanciano BioBasicsBench: 100 compiti reali di laboratorio. GPT-6 Astra arriva al 66,7%, ma sbaglia ancora le conclusioni.
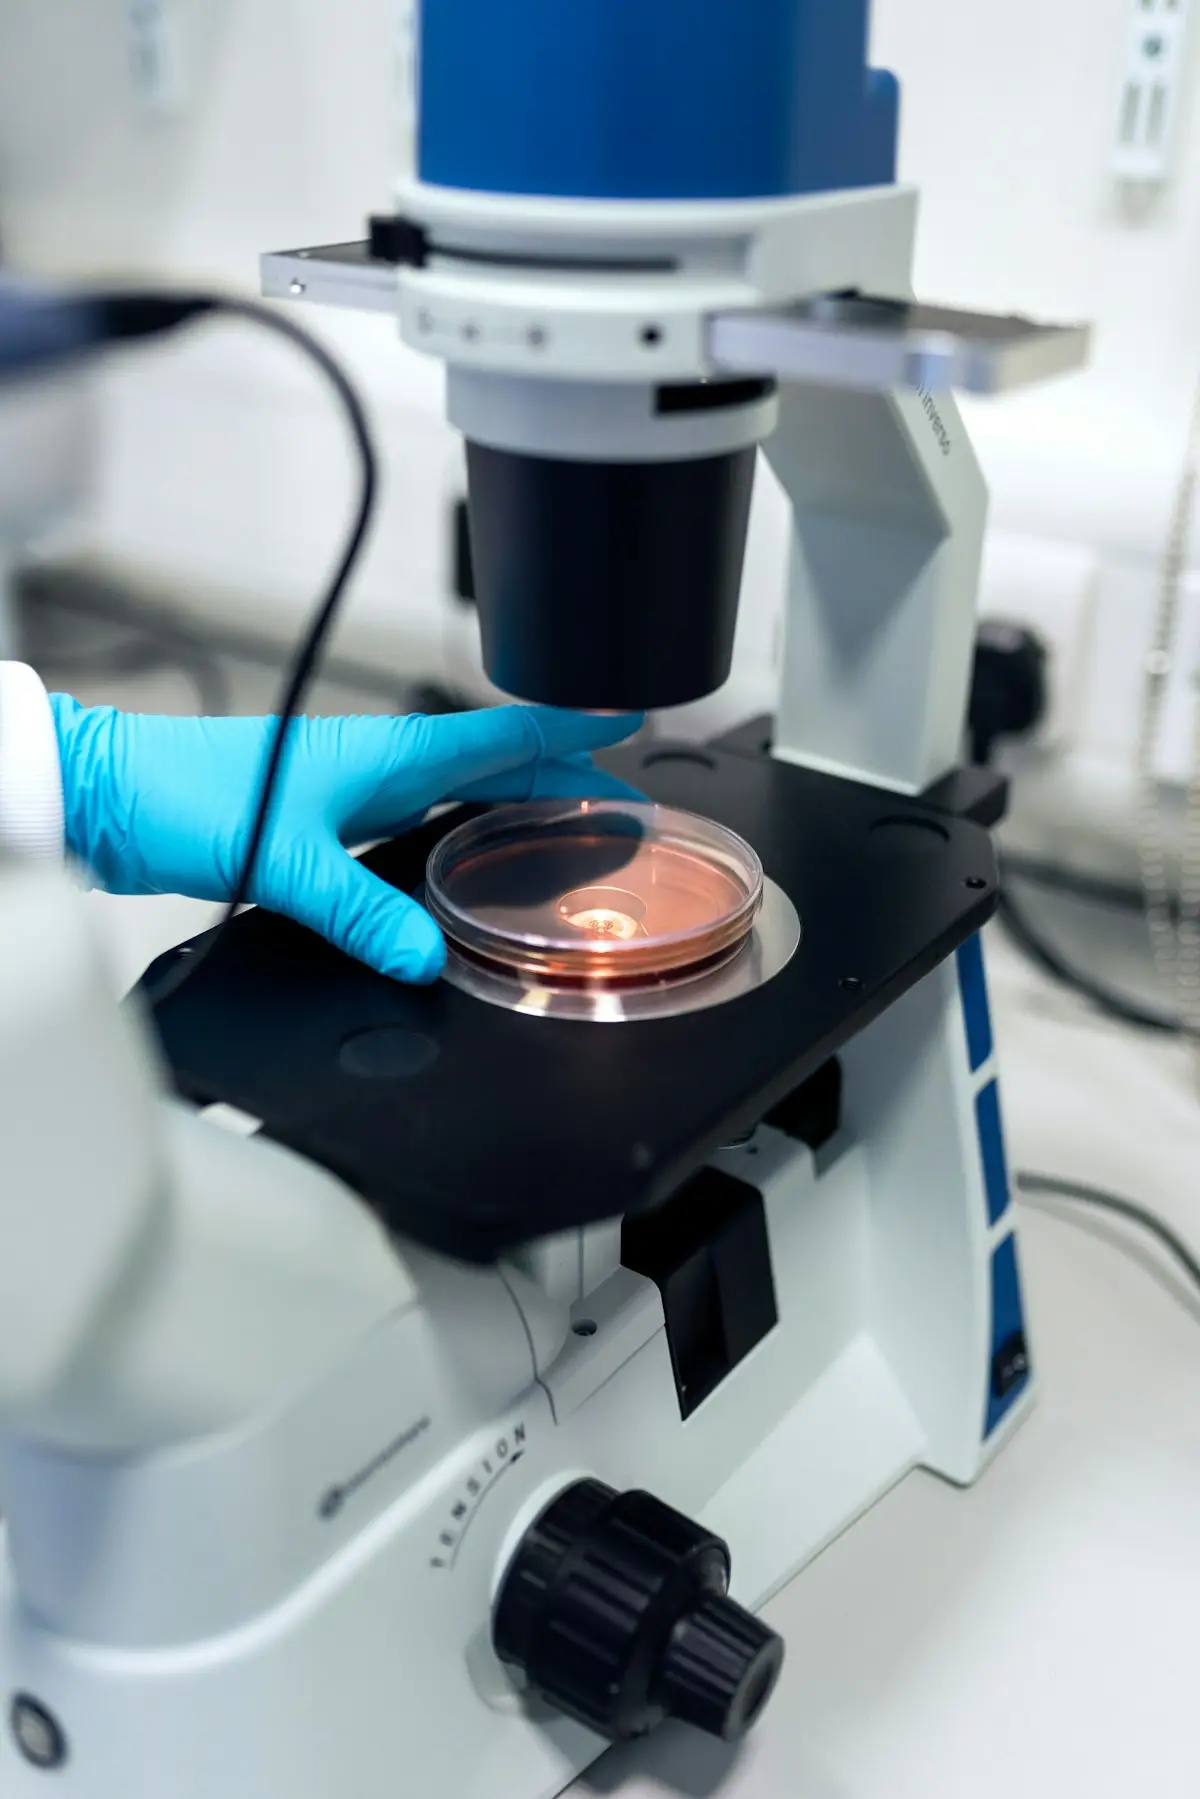
Quanto è affidabile un agente AI quando deve leggere un gel di elettroforesi, contare colonie su una piastra o decidere quali campioni portare avanti in un esperimento di clonaggio? Il 6 novembre 2026 OpenAI ha provato a rispondere con BioBasicsBench, un nuovo benchmark da 100 compiti costruito insieme a Ligo, azienda specializzata nella progettazione di enzimi. Il risultato è utile e un po’ scomodo: i modelli migliorano, ma sbagliano ancora in modo istruttivo.
In questo articolo ti spiego come funziona il test, cosa dicono i numeri e perché la lezione più importante non riguarda il punteggio, ma il tipo di errore.
Che cos’è BioBasicsBench e perché è diverso dagli altri test
Molte valutazioni scientifiche per l’AI si basano su figure già pubblicate negli articoli di ricerca: immagini pulite, selezionate perché raccontano una storia chiara. In laboratorio, invece, la realtà è più disordinata. Gli esperimenti falliscono, le immagini sono ambigue, i controlli non quadrano e qualcuno deve capire se il problema è nel protocollo, nel reagente o nell’interpretazione. BioBasicsBench nasce proprio per misurare questa parte del lavoro quotidiano, secondo la presentazione ufficiale di OpenAI.
Il benchmark contiene 100 compiti scritti da scienziati di Ligo a partire dai loro esperimenti reali. Le aree coperte sono cinque: metodi sulle proteine, imaging e citometria, quantificazione e saggi, metodi sugli acidi nucleici e clonaggio molecolare. Le prove spaziano da letture semplici, come stimare il peso molecolare di un campione di DNA da un gel, ad analisi più complesse di un saggio.
Quali dati deve interpretare l’agente
Qui sta una differenza concreta rispetto ai test testuali. L’agente riceve materiale grezzo: immagini di gel e blot, piastre con colonie, stack di microscopia, letture di sequenziamento, esportazioni di lettori di piastre, fotografie del banco e persino video di protocolli. Spesso sono accompagnati da documenti di riferimento, come le scale dei marcatori o le mappe dei plasmidi.
Il compito non è rispondere a una domanda a scelta multipla. L’agente deve restituire conclusioni strutturate, misure o raccomandazioni, e viene valutato con rubriche scritte da esperti. Ricevono credito il risultato numerico, il ragionamento a supporto e, aspetto interessante, la capacità di riconoscere quando le prove non bastano per concludere.
Come è stato costruito e verificato il test
OpenAI descrive un processo di controllo a tre livelli. Ogni compito è stato rivisto da uno scienziato di Ligo che non lo aveva scritto, poi da un ricercatore esterno con dottorato ed esperienza di laboratorio, e infine da una revisione interna finale che includeva il tentativo di un modello valutato con la rubrica. È un impianto che punta a evitare le ambiguità e le risposte di riferimento discutibili, il problema classico di molti benchmark.
La valutazione ha coperto 37 combinazioni di modello e livello di ragionamento, con cinque tentativi per compito in ciascuna impostazione, per un totale di 18.500 risultati. L’intervallo di confidenza al 95% è stato calcolato ricampionando interi compiti, non singoli tentativi, una scelta più prudente. Se vuoi capire come leggere questo tipo di numeri, conta un dettaglio: la metrica è la ricompensa media, cioè la percentuale di credito ottenuto, comprese le risposte parziali. Non equivale alla quota di compiti risolti.
I risultati: GPT-6 Astra davanti, ma senza trionfalismi
Con il massimo livello di ragionamento riportato, il modello migliore è GPT-6 Astra, con una ricompensa media del 66,7% (intervallo di confidenza 60,3-73,1%), usando in media circa 4.700 token di output per compito. Subito dietro, secondo i dati riportati da una testata specializzata, c’è GPT-6.1 Sol al 62,0%, mentre GPT-5.6 Sol si ferma al 43,8% con oltre 9.000 token per compito. I modelli più vecchi della serie scendono verso il 31-35%.
Due letture meritano attenzione. La prima: gli intervalli dei due modelli in testa si sovrappongono, quindi il loro ordine non è solido. La seconda: il distacco tra Astra e GPT-5.6 Sol è invece netto, perché il limite inferiore del primo supera il limite superiore del secondo.
C’è anche un dato di efficienza. I modelli più recenti ottengono punteggi migliori con molti meno token di output rispetto ai precedenti. Per chi usa questi strumenti in un flusso di lavoro, significa meno costo e meno attesa a parità di compito.
Dove Astra ha fatto bene
OpenAI cita alcuni esempi positivi. In un compito di imaging sulla vitalità cellulare, il modello ha segnalato una possibile interferenza di un secondo colorante e ha chiesto controlli separati. In un esercizio di clonaggio ha scartato una piastra di controllo negativo perché usava canamicina, mentre l’esperimento prevedeva ampicillina. Ha inoltre riconosciuto che alcune cellule entravano e uscivano dalla messa a fuoco per effetto dello z-stack.
Sono errori che un tecnico esperto nota, e vederli individuati da un modello è un segnale di progresso reale.
Gli errori che contano di più
La parte più interessante del rapporto riguarda i fallimenti, perché mostrano un pattern. Nel compito di colony PCR il modello ha raggruppato correttamente le bande del gel, ma ha dato per scontato che un prodotto più grande indicasse un clonaggio riuscito. Ha scelto le corsie 4, 6, 7 e 8, mentre la risposta di riferimento, basata sul confronto con i controlli, indicava le corsie 5, 9 e 10. In pratica, avrebbe portato a purificare il plasmide sbagliato.
Nel conteggio delle colonie l’agente non ha separato colonie vicine, ne ha perse alcune ben visibili e ha contato come colonie zone di agar vuote, con una sovrastima di circa il 12%. Poiché volume e diluizione sono fissi, lo stesso errore si trasferisce sulla stima dell’efficienza di introduzione del DNA. Nel caso dell’imaging, ha generalizzato che i vacuoli sono più scuri del materiale circostante, anche se le sue stesse note mostravano un contrasto variabile con la messa a fuoco.
Il filo comune è chiaro: le osservazioni sono spesso corrette, le conclusioni meno. Aspettative, risposte attese o etichette fornite finiscono per prevalere su ciò che le prove mostrano davvero.
La frase che riassume tutto
OpenAI lo dice senza giri di parole: punteggi più alti non significano ancora che i modelli sappiano esprimere giudizi affidabili in laboratorio. Aggiunge inoltre che il lavoro su queste capacità servirà a valutare le conseguenze in termini di biosicurezza. Non è un dettaglio secondario, perché un agente che interpreta bene dati sperimentali è utile alla ricerca, ma richiede anche cautela sull’accesso. Su questo fronte è utile ricordare l’approccio dell’azienda al modello per la biologia, che abbiamo raccontato nell’articolo su GPT-6 Rosalind e l’accesso verificato.
Cosa non sappiamo ancora
Come per ogni benchmark pubblicato dall’azienda che sviluppa i modelli, serve prudenza. Secondo le ricostruzioni giornalistiche consultate, sono stati testati soltanto modelli OpenAI e non risulta un confronto con una base umana. Al momento della pubblicazione non era disponibile un link pubblico a dataset, rubriche e codice di valutazione, quindi i punteggi non possono ancora essere riprodotti da terzi. Sono cifre autodichiarate, da leggere come tali.
Questo non toglie valore all’iniziativa. Un test costruito da scienziati che mostra anche i limiti del proprio modello migliore è più credibile di un grafico che celebra solo i progressi. Ma la verifica indipendente resterà il passaggio decisivo.
Perché ti riguarda, anche se non lavori in un laboratorio
La lezione si estende oltre la biologia. Gli agenti AI sono sempre più usati per leggere dati, trarre conclusioni e proporre azioni in settori dove un errore ha un costo. Lo abbiamo visto nella sicurezza informatica con GPT-6 Cyber, nell’ingegneria fisica con GPT-6 Astra che progetta hardware e nella sanità con strumenti di supporto alla diagnosi come MAI-DxO di Microsoft. In tutti questi casi la domanda giusta non è solo quanto è bravo il modello, ma quando smette di esserlo.
Per professionisti, aziende e team di ricerca, tre indicazioni pratiche emergono da BioBasicsBench. Primo, tratta l’output di un agente come un’ipotesi da verificare, non come un referto. Secondo, confronta sempre le conclusioni con i controlli e i dati grezzi, perché è lì che il modello tende a scivolare. Terzo, chiedi esplicitamente al sistema di indicare quando le prove sono insufficienti: è una competenza che i test iniziano finalmente a misurare.
Conclusioni
BioBasicsBench non dice che l’AI è pronta a sostituire i tecnici di laboratorio, e non è questo il suo scopo. Dice che i modelli sono diventati abbastanza capaci da meritare un esame serio sul lavoro reale, e che quell’esame rivela ancora un limite chiaro: osservano bene, ma concludono con troppa sicurezza.
Se lavori con agenti AI in contesti tecnici o scientifici, inizia a costruire una pratica di verifica sui risultati, non solo sui prompt. Segui intelligenzaartificiale.net per i prossimi aggiornamenti e dimmi nei commenti dove ti aspetti che questi agenti saranno più utili e dove, invece, vorresti restassero sotto stretto controllo umano.
Tutta l'AI della settimana, in 5 minuti, nella tua email
- Le guide e le notizie della settimana, divise per rubrica
- Solo ciò che conta, verificato e spiegato in italiano
- Niente spam, ti cancelli con un clic

Daniele Della Corte
Fondatore di IntelligenzaArtificiale.net · Consulente SEO e AI dal 2008
Prima della pubblicazione controlla fonti, numeri e nomi, e risponde personalmente di quello che leggi. Lavora con l'intelligenza artificiale da oltre 7 anni: ha fondato BeProud.ai e ha progettato la redazione di questo sito.
Consulenza AIVuoi applicare l'AI al tuo lavoro? Ti aiuto a scegliere cosa automatizzare e a realizzarlo.
Scopri la consulenza